Le budget de crawl désigne le nombre d’adresses que Googlebot peut et veut explorer sur un site pendant une période donnée. La notion fait beaucoup parler, parfois à tort : pour la plupart des sites elle ne pose aucun problème, alors que pour de très vastes catalogues ou des sites dont le contenu bouge sans cesse, elle devient un vrai sujet de pilotage. Cet article définit le budget, aide à savoir si votre site est concerné, recense les gaspillages les plus fréquents (facettes, paramètres, erreurs, redirections, doublons), puis détaille les leviers d’action et la lecture du rapport Statistiques sur l’exploration, avec un calculateur de profondeur à tester.
Budget de crawl : une limite de capacité et une demande d’exploration
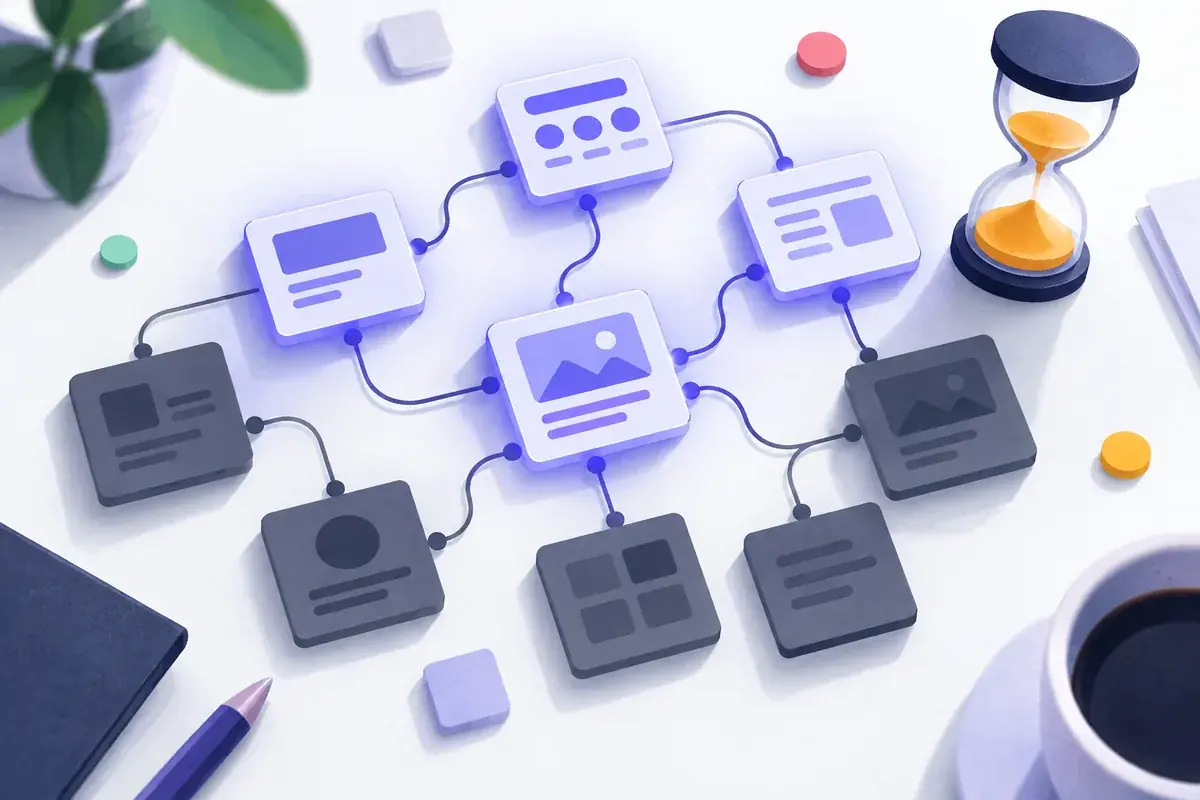
Le crawl budget n’est pas un compteur affiché quelque part : c’est une manière de résumer le temps et les ressources que Google consacre à un site. D’après la documentation Google Search Central destinée aux gros sites, il résulte de deux notions qui se combinent, la limite de capacité d’exploration et la demande d’exploration. Comprendre leur jeu évite deux erreurs symétriques : négliger le sujet quand il pèse réellement, ou y consacrer des semaines quand un site de quelques centaines de pages n’en a aucun besoin. Ce vocabulaire appartient au socle des tutoriels SEO pas à pas sur l’indexation, et le schéma ci-dessous suit le trajet d’une adresse, de sa découverte jusqu’à l’index.
La limite de capacité d’exploration, côté serveur
Google ne cherche pas à épuiser un serveur. Son robot ajuste sa cadence selon la réactivité observée : si les pages répondent vite et sans erreur, il peut multiplier les requêtes ; si les réponses ralentissent ou si des erreurs serveur apparaissent, il lève le pied. C’est la limite de capacité, qui protège le site autant que le moteur. Elle dépend de la santé de l’hébergement, du temps de réponse et de la stabilité générale, mais aussi des ressources propres à Google, qui ne sont pas infinies. Un hébergement mutualisé saturé, un pic de trafic ou une base de données lente peuvent donc réduire le nombre de pages visitées, sans que le contenu ait changé d’une virgule.
La demande d’exploration, côté intérêt
La seconde composante tient à l’intérêt que Google trouve à revenir. Cette demande grandit avec la popularité des adresses, leur fraîcheur et la taille de l’inventaire à entretenir : une page souvent citée et régulièrement mise à jour est revisitée plus volontiers qu’une page oubliée, inchangée depuis des années. Après un changement d’adresses, comme une migration, la demande peut aussi remonter pour que Google réévalue les nouvelles URL. Le budget effectif correspond au plus petit des deux facteurs : un serveur très rapide n’y change rien si Google ne voit aucune raison de revenir, et une forte demande se heurte à un serveur trop lent. Dans les deux cas, le levier est la qualité du site, pas un réglage caché.
Explorer n’est pas indexer
Un robot qui visite une page ne l’indexe pas automatiquement : le budget ne règle que la première étape, l’exploration. Une adresse peut être explorée puis écartée de l’index, ou rester seulement détectée, sans visite. Ces deux situations apparaissent dans le rapport d’indexation des pages de la Search Console, sous les statuts « explorée, actuellement non indexée » et « détectée, actuellement non indexée ». Le premier signale souvent une page jugée peu utile après lecture ; le second peut trahir un manque de ressources d’exploration ou un site trop vaste pour sa notoriété. Interpréter correctement ces statuts évite de réclamer plus de budget quand le vrai sujet est la qualité du contenu.
Quels sites sont concernés par le budget de crawl ?
Pour la majorité des sites, la question ne se pose pas. D’après la documentation Google Search Central, le sujet touche surtout les très grands sites (de l’ordre du million de pages, au contenu modérément changeant), ceux de plus de 10 000 pages dont le contenu évolue très vite, et les sites où beaucoup d’adresses restent « détectées, actuellement non indexées » ; ces seuils sont à vérifier dans la documentation officielle. Un site vitrine, un blog ou un catalogue de taille moyenne s’explore sans difficulté. Le tableau ci-dessous classe les situations, mais avant toute analyse, assurez-vous qu’un sitemap XML propre liste les adresses utiles : il aide Google à découvrir ce qui compte.
| Situation du site | Faut-il s’en préoccuper ? |
|---|---|
| Site vitrine ou blog de quelques centaines de pages | Non : soigner le contenu et les liens internes suffit. |
| Quelques milliers de pages, mises à jour rares | Peu probable : surveiller l’indexation plutôt que l’exploration. |
| Catalogue très vaste, de l’ordre du million de pages | Oui : l’inventaire dépasse ce que Google visite à chaque passage. |
| Actualité, petites annonces, stocks changeants | Oui : la fraîcheur compte, la découverte doit être rapide. |
| E-commerce avec filtres et facettes | À surveiller : les combinaisons créent une multitude d’adresses proches. |
| Site en migration ou en refonte | Temporaire : la demande monte puis se stabilise. |
| Beaucoup d’adresses détectées mais non indexées | Signal d’alerte à analyser avant toute autre chose. |
Les seuils de taille cités par Google
Les chiffres évoqués par la documentation sont des ordres de grandeur, pas des frontières administratives. Un site de 200 000 pages dont les adresses sont propres, rapides et bien reliées peut très bien être exploré intégralement, tandis qu’un site plus petit mais encombré de variantes inutiles peut montrer des signes de saturation. La donnée décisive est donc observable : un délai anormal entre la publication d’une page et sa première visite, des sections entières détectées mais jamais explorées, ou des mises à jour qui mettent des semaines à être prises en compte. Tant que ces symptômes n’apparaissent pas, mieux vaut consacrer le temps disponible aux contenus et au maillage.
Les sites dont le contenu change vite
Un site d’actualité, une place de marché d’annonces ou un catalogue dont les stocks varient génèrent sans cesse de nouvelles adresses et en retirent d’autres. Pour eux, la rapidité de découverte compte : une annonce visitée trop tard a peut-être déjà disparu. Quelques pratiques aident : un sitemap mis à jour automatiquement, avec une lastmod fiable plutôt que décorative, des liens depuis des pages très visitées vers les nouveautés, et des codes de réponse corrects pour les contenus retirés (410 ou 404 plutôt qu’une redirection vers l’accueil). Il faut aussi nettoyer les pages expirées, qui entretiennent un inventaire gonflé d’adresses mortes à revisiter régulièrement.
Le e-commerce à facettes, cas d’école
Les boutiques en ligne cumulent presque tous les facteurs de risque : un grand nombre de fiches, des stocks mouvants et surtout des filtres qui multiplient les adresses. Un rayon de chaussures filtrable par taille, couleur, matière, marque et prix, avec plusieurs tris possibles, peut engendrer des milliers de combinaisons pour une centaine de produits. La plupart n’ont aucune valeur de recherche, mais chacune est un lien que le robot peut suivre. Il faut donc décider quelles combinaisons méritent une page indexable à part entière, par exemple une marque ou une couleur très demandée, et traiter toutes les autres par des canonical, des liens non explorables ou des règles de blocage.
Les gaspillages de budget de crawl les plus courants
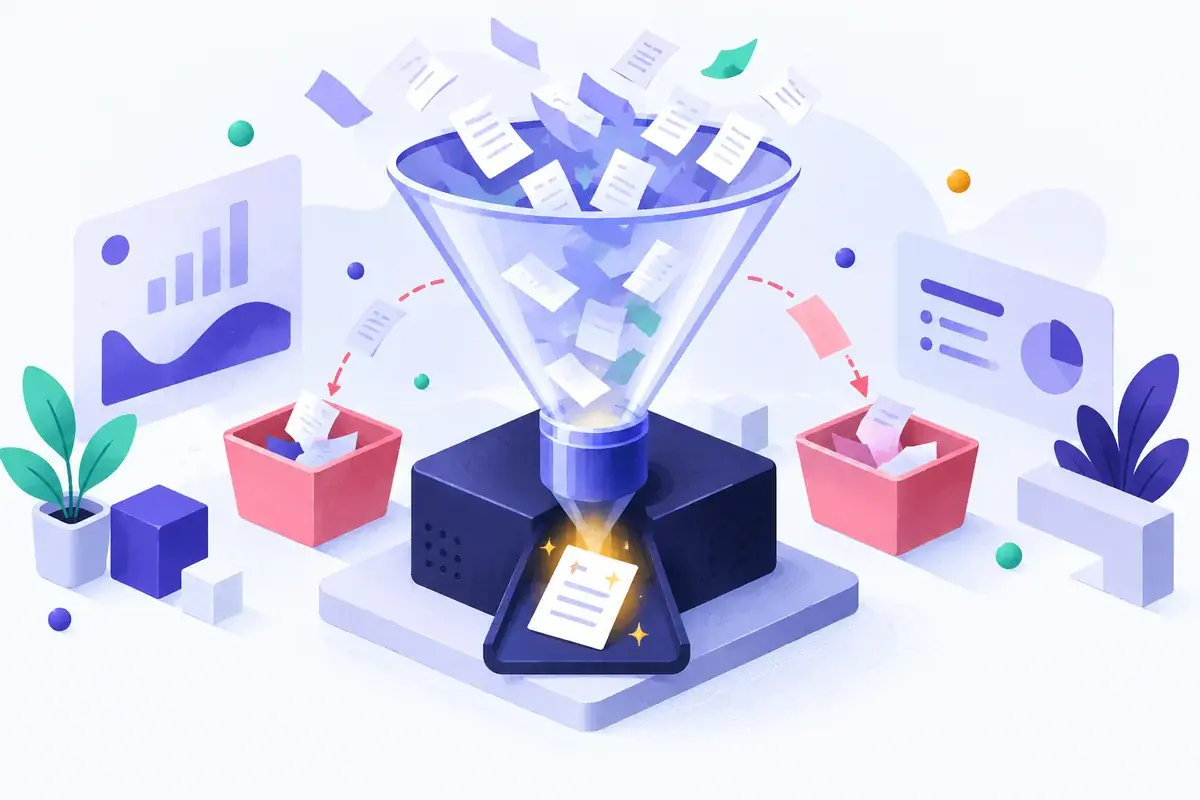
Un site gaspille son budget lorsque le robot passe du temps sur des adresses qui ne méritent ni exploration ni index. Le phénomène a presque toujours la même origine : un site qui génère plus d’URL que de pages réellement distinctes. Les causes se rangent en quelques familles, détaillées plus bas, et le schéma montre comment le robot répartit son attention entre pages utiles et impasses. Un serveur lent aggrave la situation, puisque chaque réponse tardive réduit le nombre de visites possibles ; les Core Web Vitals mesurent autre chose, l’expérience vécue par les visiteurs, mais les chantiers de performance servent les deux objectifs à la fois.
Facettes et paramètres d’URL
Les filtres de tri, de couleur, de prix ou de disponibilité transforment une catégorie en une multitude d’adresses, chacune presque identique à sa voisine. Les paramètres de session, de suivi publicitaire ou d’affichage ajoutent un second niveau de duplication : une catégorie triée par prix, puis filtrée par couleur, puis triée dans l’autre sens, peut produire trois adresses pour un même contenu. Le robot perd alors du temps sur ces variantes plutôt que sur des fiches récentes. Les solutions relèvent d’un arbitrage : limiter les combinaisons indexables, déclarer une canonical vers la version de référence, retirer les liens vers les filtres sans intérêt de recherche, ou bloquer certains motifs dans le robots.txt lorsque ces pages ne doivent jamais être visitées.
Erreurs, boucles et chaînes de redirections
Chaque requête vers une page en erreur 404 ou 5xx est une visite sans valeur, et un volume élevé d’erreurs serveur peut en outre pousser Google à ralentir sa cadence. Les redirections posent un problème voisin : une chaîne où A renvoie vers B, qui renvoie vers C, consomme plusieurs requêtes pour un seul contenu, et une boucle n’aboutit jamais. La règle est simple : tout lien interne pointe directement vers l’adresse finale. Pour situer votre site, le calculateur ci-dessous estime la profondeur de clic théorique d’après le nombre de pages et de liens utiles par page ; plus une page est éloignée de l’accueil, moins elle reçoit de visites, et les valeurs saisies ne sont que des hypothèses.
Doublons et pages sans valeur
Les contenus dupliqués dispersent l’exploration : versions avec et sans barre oblique finale, http et https, www et sans www, pages d’impression, archives par date ou par auteur sans texte propre, résultats de la recherche interne ouverts aux robots. Google regroupe ces variantes derrière une adresse canonique, mais il doit d’abord les visiter pour les comparer, ce qui coûte du budget. Les pages quasi vides, les résultats de recherche interne et les calendriers infinis forment des pièges à robots : chaque lien en génère un autre, sans fin. Un crawler configuré comme Googlebot permet de repérer ces zones avant qu’elles ne gonflent la liste des adresses détectées mais non explorées.
Optimiser le budget de crawl : leviers et suivi dans la Search Console
Optimiser le budget ne consiste pas à courir après davantage de visites, mais à orienter celles que Google accorde vers les pages qui comptent. Quatre leviers y contribuent : une arborescence plate, un serveur réactif, des fichiers de guidage propres (sitemap et robots.txt) et un suivi régulier des statistiques d’exploration. Chacun agit sur un facteur différent de l’équation, la capacité pour les uns, la demande pour les autres, et le cadran ci-dessous résume les trois indicateurs à lire en premier. Aucun réglage ne garantit une exploration plus fréquente : l’objectif est de lever les freins, puis de laisser Google constater que le site mérite ses visites.
Arborescence plate et serveur rapide
Une arborescence plate rapproche les pages de l’accueil : trois clics suffisent le plus souvent à atteindre une page importante, grâce à des pages de catégories bien reliées et à un maillage contextuel. Côté serveur, la réactivité compte directement : un temps de réponse court, une mise en cache, la compression des fichiers et un hébergement dimensionné pour les pointes de trafic, avec des codes de statut fiables. Évitez aussi les ressources inutiles, car chaque fichier demandé pour afficher une page compte comme une requête. Un robot qui obtient de bonnes réponses rapides peut explorer davantage, mais cela dépend aussi de la demande : un serveur véloce ne remplace jamais des pages utiles.
Sitemaps propres et robots.txt ciblé
Le sitemap ne doit contenir que des adresses canoniques, répondant en 200 et destinées à l’index ; un fichier est limité à 50 000 URL ou 50 Mo non compressés, et un fichier d’index de sitemaps permet d’en regrouper plusieurs. Une lastmod exacte aide Google à repérer ce qui a changé, alors que priority et changefreq sont ignorés. Le robots.txt sert à écarter les zones sans valeur de recherche, comme certains paramètres ou la recherche interne, mais il ne désindexe pas : une page bloquée ne peut pas montrer sa balise noindex. Google ne lit qu’environ les 500 premiers Kio du fichier, ce qui impose de le garder compact.
Lire le rapport Statistiques sur l’exploration
Dans la Search Console, le rapport Statistiques sur l’exploration (rubrique Paramètres) résume l’activité de Googlebot : nombre de requêtes, volume téléchargé, temps de réponse moyen, ainsi que la répartition par code de réponse, par type de fichier et par objectif, découverte ou actualisation. Trois lectures sont utiles. Une chute brutale des requêtes accompagnée d’un temps de réponse en hausse oriente vers le serveur ; une part élevée de réponses 404 ou de redirections désigne un maillage à corriger ; une exploration dominée par des paramètres révèle une fuite vers les facettes. Le rapport donne des tendances de fond, pas un compteur de budget : il indique où chercher.
- Mesurer l’existantRelever requêtes, temps de réponse et codes d’erreur dans le rapport d’exploration.
- Éliminer le superfluTraiter facettes, paramètres, doublons et chaînes de redirections.
- Soulager le serveurCache, compression, hébergement adapté, ressources allégées.
- Suivre et ajusterComparer les courbes après chaque chantier avant d’en ouvrir un autre.
Mon site de 500 pages doit-il se soucier de son budget de crawl ?
Très probablement pas. À cette échelle, Google explore l’ensemble du site sans difficulté si les pages répondent correctement et sont reliées entre elles. Vos efforts rapportent davantage dans la qualité des contenus, le maillage interne et la vitesse d’affichage que dans l’optimisation fine de l’exploration.
Un noindex fait-il économiser du budget de crawl ?
Pas vraiment. Pour lire un noindex, Google doit d’abord visiter la page, qui consomme donc une requête, même si elle est revue moins souvent par la suite. Pour qu’une zone ne soit jamais visitée, le robots.txt convient, mais il empêche alors de lire la balise noindex : le choix dépend de l’objectif.
Peut-on demander à Google d’explorer plus souvent un site ?
Non, il n’existe pas de réglage pour augmenter l’exploration. Les leviers sont indirects : un serveur rapide, des pages utiles, des liens clairs et un sitemap exact. Quand une page importante vient de changer, l’inspection d’URL permet de demander une nouvelle visite ponctuelle, sans effet sur le budget global.
À lire aussi dans la même rubrique
Qu’est-ce que l’intention de recherche et comment l’analyser ?
Intention de recherche : les familles d’intentions, comment les lire dans les résultats de Google et adapter angle, form…
Comment créer un sitemap XML utile pour Google ?
Sitemap XML : ce qu’il apporte, le contenu d’un bon fichier, les sitemaps spécialisés, la soumission dans la Search Cons…
Comment faire une recherche de mots-clés efficace ?
Recherche de mots-clés : partez du vocabulaire de vos clients, croisez les sources, qualifiez chaque expression et organ…