
La pagination et les facettes d’un site multiplient les adresses sans multiplier les contenus : une simple catégorie peut engendrer des centaines d’URL presque identiques, que les robots explorent au détriment des pages utiles. Ce tutoriel pose le problème (explosion d’URL, quasi-doublons, exploration gaspillée), explique comment paginer proprement (liens crawlables, canonical auto-référent, abandon de rel prev et next comme signal), détaille le tri entre facettes à indexer et facettes à bloquer, puis présente des alternatives et des méthodes de surveillance, avec un quiz pour tester les idées reçues.
Pagination et facettes : comment les URL se multiplient et pourquoi cela coûte
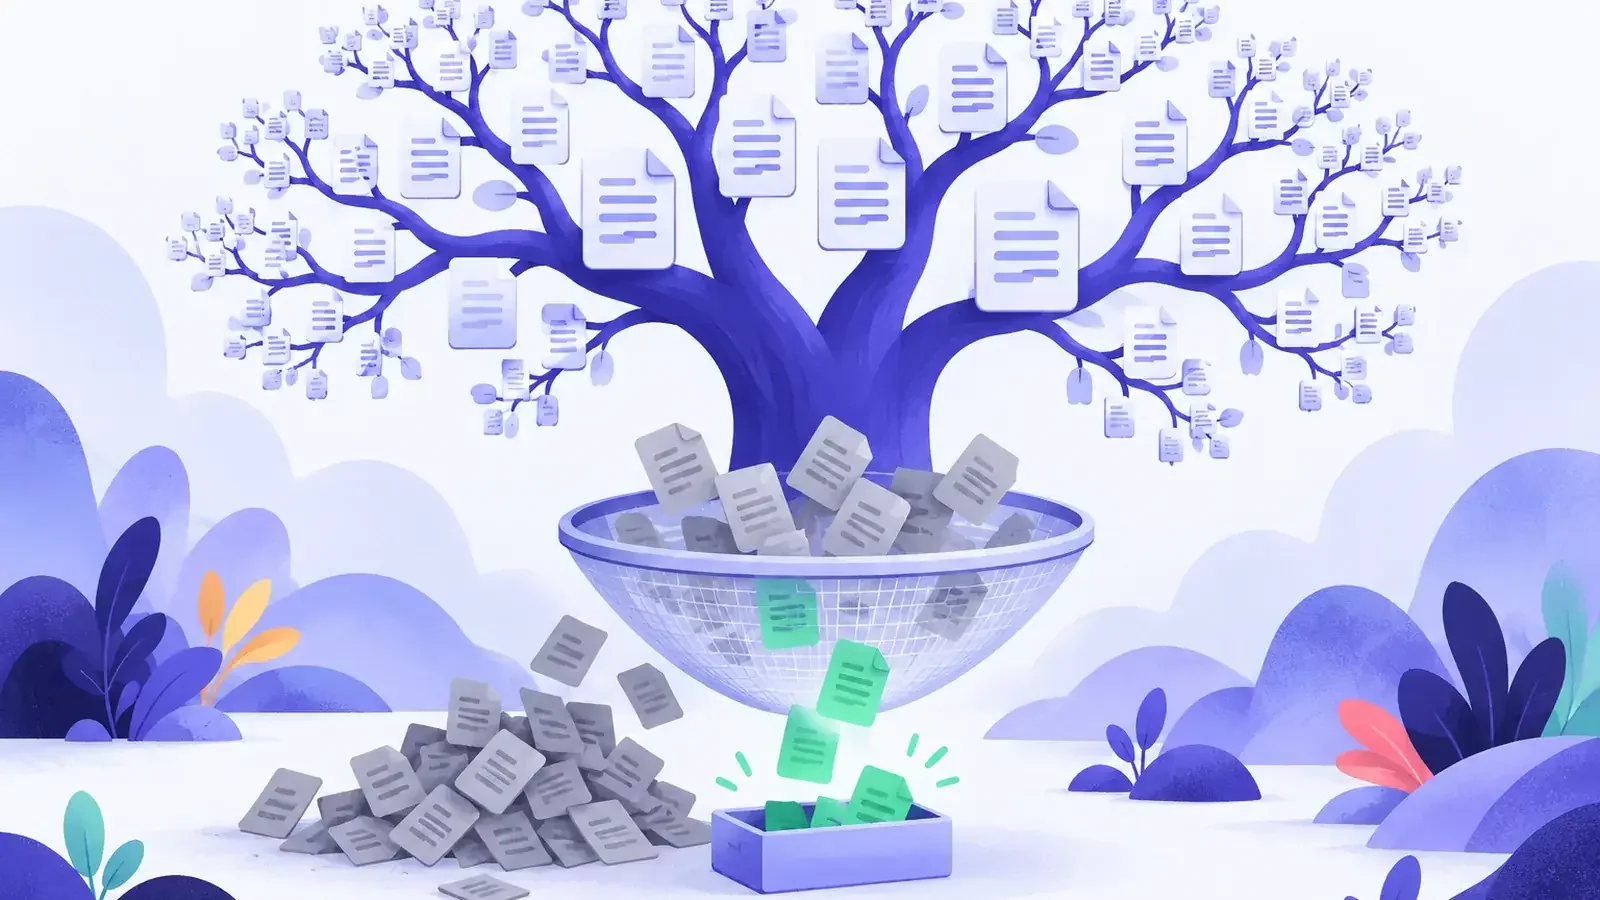
Ce tutoriel prolonge les tutoriels SEO pas à pas consacrés à l’exploration et à l’indexation. Il commence par le constat, car la plupart des sites touchés ne s’en aperçoivent qu’après coup : une catégorie, un jeu de filtres, un tri, une page suivante, et le nombre d’adresses possibles dépasse de loin celui des contenus. Le schéma ci-dessous montre cette ramification sur quelques niveaux. Les trois parties suivantes la décrivent sous trois angles : le volume d’URL, la ressemblance des pages produites et le temps d’exploration qu’elles absorbent. Comprendre cette mécanique évite de corriger au hasard des symptômes dont l’origine est toujours la même : trop d’adresses pour trop peu de contenus distincts.
Une explosion d’adresses à partir d’une seule liste
Chaque filtre ajoute un paramètre à l’adresse, et chaque combinaison de paramètres produit une URL différente : couleur, taille, marque, tri par prix, nombre d’éléments par page, numéro de page. Les possibilités se multiplient plus vite qu’elles ne s’additionnent : trois filtres de quelques valeurs chacun, combinés dans n’importe quel ordre, donnent des dizaines d’adresses pour une seule catégorie, et l’ordre des paramètres peut lui-même créer des doublons. Un site de taille moyenne expose ainsi, sans le savoir, bien plus d’adresses que de contenus réels. Cette explosion combinatoire se repère avec un crawler qui compte les URL découvertes, comparées aux pages que l’on veut voir indexées.
Des contenus quasi identiques sous des adresses différentes
Une page filtrée affiche presque les mêmes éléments que la page de départ, dans un ordre différent ou en plus petit nombre. Le titre, la description, le texte d’introduction et les liens sont souvent identiques. Pour un moteur, ces pages forment des familles de quasi-doublons : il doit choisir laquelle représenter, regrouper les autres, et peut en retenir une qui n’est pas celle prévue. La balise canonical est un signal et non une directive : d’après la documentation Google Search Central, Google choisit l’URL canonique finale. Laisser faire revient à diluer les signaux entre des adresses qui se concurrencent, au lieu de les concentrer sur la page principale.
Une exploration gaspillée au détriment des pages utiles
Les robots disposent d’un temps d’exploration limité pour chaque site. Quand une grande partie des visites est consommée par des milliers de combinaisons de filtres, les pages importantes (nouveaux produits, articles mis à jour) peuvent être redécouvertes plus tard. Cet effet concerne surtout les sites volumineux ; un petit site sera rarement gêné, mais son rapport d’indexation peut quand même se remplir de statuts comme « détectée, actuellement non indexée » ou « explorée, actuellement non indexée ». Un tel signal ne prouve rien à lui seul : il invite à regarder quelles familles d’adresses s’accumulent, et à décider lesquelles méritent d’exister dans l’index, car un crawl budget mal employé ralentit surtout les mises à jour.
La pagination d’un site : liens crawlables, canonical et fin de rel prev et next
Paginer consiste à découper une longue liste en pages numérotées. C’est légitime et fréquent, et cela reste une bonne option quand le nombre d’éléments est important. Les règles de base tiennent en peu de lignes, résumées dans le tableau ci-dessous : des liens que le robot peut suivre, une adresse propre à chaque page, une canonical qui désigne la page elle-même. Il faut aussi penser aux changements : en refondant une pagination, les anciennes adresses se traitent avec des redirections 301 vers leurs équivalents, afin de ne perdre ni les liens existants ni la continuité de l’exploration, ce qui suppose de dresser d’abord la correspondance entre anciennes et nouvelles adresses.
| Élément | Bonne pratique |
|---|---|
| Liens entre pages | De vrais liens HTML avec une adresse, visibles dans le code ou le rendu final. |
| Adresse de chaque page | Une URL propre et stable, par exemple /page/2/ ou ?page=2. |
| Canonical | Auto-référente : chaque page paginée désigne sa propre adresse. |
| Page 1 | Une seule version, sans doublon ?page=1 redirigé vers l’adresse de base. |
| Titres | Distincts d’une page à l’autre, avec le numéro de page. |
| Rel prev et next | Plus utilisés par Google comme signal d’indexation ; sans danger. |
Des liens crawlables, dans le code et pas seulement au clic
Le robot découvre les pages suivantes en suivant des liens. Il lui faut donc de vrais éléments a dotés d’un attribut href qui contient l’adresse de destination, présents dans le code source ou dans le rendu final de la page. Un bouton géré par un script sans adresse, un lien dont la cible est écrite dans un événement de clic, ou un défilement qui charge la suite sans jamais exposer d’URL ne sont pas des chemins fiables. Le test est simple : afficher le code de la page, ou utiliser l’inspection d’URL de la Search Console, et vérifier que la page suivante apparaît comme un lien ordinaire. Sans lien, les produits de la page 2 et au-delà peuvent n’être jamais découverts.
Le canonical auto-référent et la fin de rel prev et next
Chaque page d’une liste paginée déclare en principe comme canonique sa propre adresse. Pointer toutes les pages vers la première, par souci de concentration, revient à dire à Google que les produits des pages suivantes n’existent pas, et peut gêner leur découverte. Les balises rel prev et rel next, de leur côté, ne sont plus utilisées par Google comme signal d’indexation, d’après une annonce de 2019 ; les conserver n’est pas nuisible, d’autres moteurs ou outils peuvent les lire, mais elles ne remplacent pas les liens. Un canonical auto-référent reste un signal que Google peut ne pas suivre : l’inspection d’URL affiche la canonique réellement retenue.
Titres, contenus et page 1 : éviter les doublons de la liste
Les pages paginées partagent souvent le même titre et la même description. Ajouter le numéro de page au titre et au titre principal les distingue sans les alourdir. Le texte d’introduction de la catégorie n’a pas besoin d’être répété sur chaque page : on peut le réserver à la première. Pour la page 1, une seule version doit exister : l’adresse avec ?page=1 redirige vers l’adresse sans paramètre. Enfin, les liens vers les pages suivantes se limitent à un nombre raisonnable (précédent, suivant, quelques numéros, dernière page) pour que le parcours de pagination reste lisible pour le visiteur comme pour le robot.
Les facettes de filtre : lesquelles indexer, lesquelles bloquer
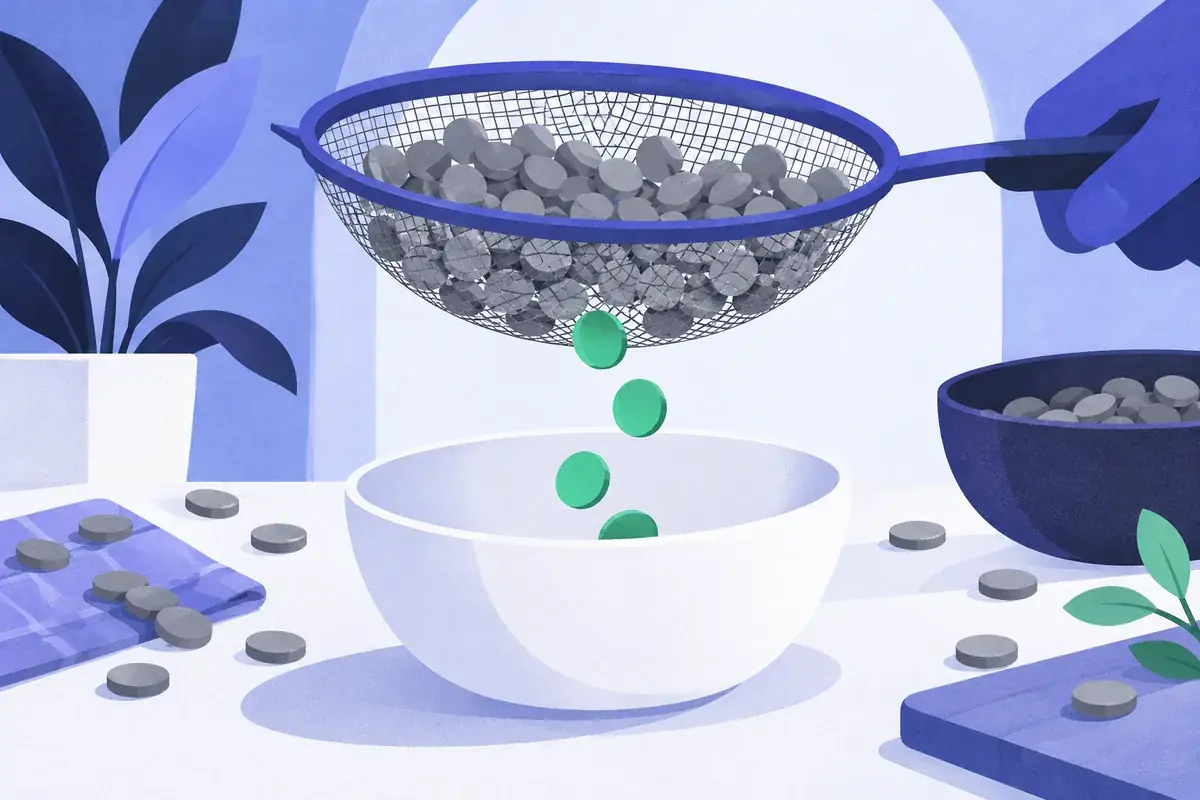
Une facette est un filtre qui restreint une liste selon un critère : couleur, marque, prix, matière. La question n’est pas de les supprimer, car elles servent les visiteurs, mais de décider lesquelles méritent une adresse dans l’index. Le sitemap XML joue ici un rôle de vitrine : il ne devrait contenir que les adresses que l’on souhaite voir indexées, ce qui oblige à trancher. L’entonnoir ci-dessous montre la sélection progressive des adresses générées vers quelques pages retenues ; les paragraphes suivants détaillent les critères, les paramètres et le choix de l’outil. Le même raisonnement s’applique aux tris et aux affichages alternatifs, qui produisent eux aussi des adresses.
Indexer une facette quand une demande réelle existe
Une facette mérite d’être indexée quand des internautes la recherchent réellement, par exemple une marque ou une couleur associée à un type de produit. La Search Console, les recherches internes du site et l’observation des pages de résultats donnent des indices de demande. Il faut ensuite que la page apporte quelque chose de propre : un titre et un texte adaptés, une liste suffisamment fournie, une adresse lisible et stable. Si ces conditions sont réunies, la facette devient une vraie page de destination, intégrée au maillage et au sitemap. Sinon, elle reste un outil de navigation, qui sert le visiteur sans occuper l’index.
Paramètres d’URL : trier, ordonner, neutraliser
Certains paramètres ne changent pas le contenu : identifiant de session, suivi marketing, tri qui réordonne la même liste, nombre d’éléments par page. Ils produisent pourtant des adresses distinctes. La première défense est de les éviter : générer les filtres sans adresse propre quand c’est possible, ordonner les paramètres de façon constante, retirer les identifiants inutiles des liens internes. Pour ceux qui subsistent, la canonical vers la version sans paramètre regroupe les signaux, tandis que les règles d’exploration limitent la découverte. Un paramètre sans effet sur le contenu n’a aucune raison d’apparaître dans les liens internes. Le quiz suivant teste quelques réflexes sur ces choix.
Vrai ou faux ?
Google utilise encore rel prev et next comme signal d’indexation.
Google a annoncé en 2019 ne plus s’en servir comme signal. Ces balises ne nuisent pas, mais ce sont les liens crawlables qui permettent de découvrir les pages suivantes.
Une canonical vers la page 1 sur toutes les pages paginées est recommandée.
Chaque page paginée se désigne en principe elle-même. Pointer vers la première peut masquer les pages suivantes, et la canonical reste un signal que Google peut ignorer.
Une page bloquée par robots.txt ne peut pas voir sa balise noindex.
Le robot ne télécharge pas la page : il ne lit jamais la consigne. Pour désindexer, laissez la page explorable avec noindex ou X-Robots-Tag.
Toutes les combinaisons de filtres doivent figurer dans le sitemap.
Le sitemap signale les adresses à indexer. Y inscrire des combinaisons sans demande réelle contredit les autres signaux et gaspille l’exploration.
Noindex, canonical ou robots.txt : choisir selon le cas
Trois outils existent, avec des effets différents. Le noindex, en balise meta robots ou en en-tête X-Robots-Tag, retire une page de l’index, à condition que le robot puisse l’explorer. La canonical regroupe des variantes autour d’une adresse préférée, comme signal que Google peut ne pas suivre. Le fichier robots.txt empêche l’exploration, ce qui économise des visites mais ne retire rien de l’index et interdit de lire un noindex. Le choix selon le cas se résume ainsi : canonical pour des variantes très proches d’une page principale, noindex pour des pages utiles aux visiteurs mais sans valeur pour l’index, robots.txt pour de vastes familles d’adresses sans intérêt.
Alternatives à la pagination et surveillance des URL générées
Réduire le problème à la source vaut souvent mieux que de le contenir : moins de pages creuses, des listes plus intelligentes, et une surveillance qui détecte les dérives avant qu’elles ne pèsent. Les solutions techniques existent, mais elles se choisissent selon le site, le public et les capacités de l’équipe. La carte de chaleur ci-dessous représente l’exploration d’un site type par famille d’adresses, et donne une idée de ce que l’on cherche à repérer : des zones très visitées par les robots qui ne correspondent à aucune page utile. Le suivi régulier est ce qui garde la structure saine dans la durée, et permet de réagir sans attendre.
Chargement progressif : un bouton, mais aussi des liens
Le défilement infini et le bouton « voir plus » améliorent l’expérience sur mobile, mais ils posent la même question qu’une pagination : le robot peut-il atteindre tous les éléments ? D’après la documentation Google Search Central, il vaut mieux proposer des adresses distinctes accessibles par des liens, même si l’interface charge la suite par script. Concrètement, une page de liste complète, avec un lien vers la page suivante, accompagne le chargement progressif ; l’interface met à jour l’adresse au fil du défilement. Une solution de repli crawlable évite que les produits situés après la première vague de chargement deviennent invisibles. L’inspection d’URL confirme ce que Google voit réellement.
Pages numérotées
La solution classique : chaque page a son adresse et ses liens, simple à explorer et à contrôler.
Bouton voir plus
Un compromis pour mobile, à condition qu’un lien réel mène à la page de liste suivante.
Défilement infini
Agréable, mais il exige des adresses de repli explorables pour ne pas masquer la suite de la liste.
Des pages catégories riches plutôt que des listes interminables
Une catégorie qui présente ses sous-catégories, un texte d’introduction utile, des sélections mises en avant et quelques liens vers les filtres vraiment demandés réduit le besoin de pages de résultats filtrées. Elle répond aux recherches larges et sert de porte d’entrée aux recherches plus précises. Quand une combinaison de filtres est très demandée, la transformer en sous-catégorie à part entière, avec sa propre adresse, son titre et son contenu, est plus propre qu’une URL à paramètres. Cette page catégorie enrichie concentre les signaux, simplifie le maillage et évite de gérer des centaines d’adresses de filtre, tout en restant plus agréable à lire pour les visiteurs.
Surveiller les URL générées dans la durée
Un site qui évolue génère de nouvelles adresses sans qu’on y pense : un filtre ajouté, un paramètre de campagne, une nouvelle option de tri. Une surveillance légère suffit : compter régulièrement les URL découvertes par un crawler et les comparer au nombre de pages attendues, relire le rapport d’indexation des pages de la Search Console pour repérer les familles qui grossissent, examiner les journaux du serveur quand ils sont accessibles. Une hausse soudaine du nombre d’adresses explorées ou exclues mérite une enquête avant de devenir un problème. Notez chaque règle posée (noindex, canonical, blocage) avec sa date, pour pouvoir la réviser.
Faut-il mettre les pages paginées en noindex ?
En général non : elles portent les liens vers des produits ou des articles qui n’ont parfois pas d’autre chemin de découverte. Laissez-les explorables, avec une canonical qui désigne chaque page elle-même et des titres distincts. Vérifiez qu’aucun contenu important ne dépend d’elles seules.
Que devient rel prev et next aujourd’hui ?
Google ne les utilise plus comme signal d’indexation, d’après l’annonce de 2019. Elles ne nuisent pas et d’autres moteurs ou outils peuvent les lire, mais seuls des liens crawlables vers les pages suivantes assurent leur découverte.
Comment savoir quelles facettes ont une vraie demande ?
Croisez les requêtes visibles dans la Search Console, les recherches internes du site et l’observation à la main des pages de résultats. Une facette utile correspond à une expression que des personnes tapent réellement. Les indices restent approximatifs : testez quelques facettes avant de généraliser.
À lire aussi dans la même rubrique
Comment construire un cocon sémantique ?
Cocon sémantique : principe des piliers et satellites, conception, liens montants et descendants, maintenance et suivi d…
Comment fonctionnent les redirections 301 et 302 pour le SEO ?
Redirections 301 et 302 : sens des codes 301, 302, 307 et 308, bonnes pratiques, cas courants (https, www, 404) et plan…
Comment structurer ses titres avec les balises Hn ?
Balises Hn : rôle de chaque niveau, règles de hiérarchie, rédaction de titres informatifs et erreurs à éviter pour un pl…